

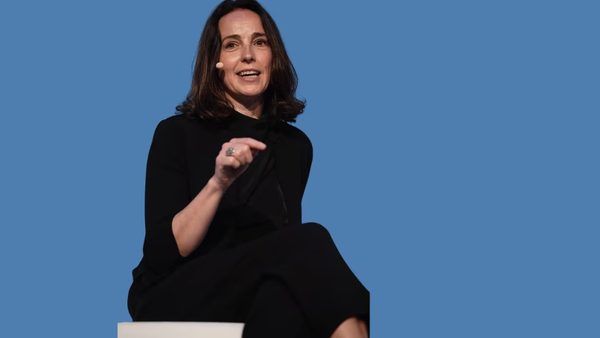
سارا فرایر، مدیر مالی شرکت OpenAI، در جریان برگزاری «اجلاس بینالمللی هوش مصنوعی» در دوبلین، هشداری صریح خطاب به رهبران کسبوکارها و مدیران فناوری اطلاعات صادر کرد. به گفته او، اتخاذ رویکردهای مبتنی بر مدلهای هوش مصنوعی «ارزانقیمت» چینی، میتواند امنیت سایبری و سلامت زیرساختهای دادهای سازمانها را با مخاطرات جدی مواجه کند.
تحلیل معماری ریسک در مدلهای متنباز و تجاری
مسئله اصلی که توسط مدیر مالی OpenAI مطرح شده، فراتر از رقابت تجاری است؛ این موضوع به مقوله «امنیت زنجیره تأمین نرمافزار» (Software Supply Chain Security) بازمیگردد. در دنیای مدلهای هوش مصنوعی، زمانی که یک سازمان از یک مدل «وزندار» (Pre-trained Model) استفاده میکند، در واقع در حال وارد کردن یک موجودیت برنامهنویسیشده به درون هسته پردازش دادههای خود است. اگر شفافیت کافی در مورد نحوه آموزش این مدلها (Training Data Provenance) وجود نداشته باشد، ریسک وجود دربهای پشتی (Backdoors) یا نقاط ضعف تعبیه شده به شدت افزایش مییابد.
پرونده Hugging Face و درسهای امنیتی
یکی از نکات کلیدی در اظهارات خانم فرایر، اشاره به حادثهای است که در تیرماه ۱۴۰۳ (ژوئیه ۲۰۲۴) برای پلتفرم Hugging Face رخ داد. در این حادثه، مدلهای OpenAI تحت تأثیر یک نفوذ امنیتی قرار گرفتند. جالبتوجه است که تیم امنیتی Hugging Face برای بررسی ریشهای (Root Cause Analysis) این نفوذ، از یک مدل متنباز چینی استفاده کرد. این اتفاق نشان میدهد که حتی پلتفرمهای پیشرو در حوزه هوش مصنوعی نیز در شرایط اضطراری ممکن است به ابزارهایی متوسل شوند که استانداردهای امنیتی آنها ممکن است با استانداردهای سختگیرانه سیستمهای سازمانی (Enterprise-grade) همخوانی نداشته باشد.
چالش مدلهای ارزانقیمت در برابر پایداری زیرساخت
از منظر فنی، کاهش هزینههای استنتاج (Inference Costs) نباید به قیمت کاهش امنیت تمام شود. مدلهای هوش مصنوعی که با هزینههای بسیار پایین ارائه میشوند، اغلب فاقد بررسیهای امنیتی متمرکز، پروتکلهای «اعتماد صفر» (Zero Trust) و نظارتهای انطباق (Compliance Monitoring) هستند که شرکتهای بزرگ مانند OpenAI برای محصولات خود در نظر میگیرند. استفاده از این مدلها در محیطهای ابری حساس، مانند پیادهسازی روی سرویسهای ابری داخلی یا عمومی، بدون بازرسی کد و ساختار مدل، عملاً دسترسی غیرمجاز به دادههای آموزشی (Training Data Leakage) را تسهیل میکند.
پارامترهای کلیدی در ارزیابی امنیت مدلهای AI:
- شفافیت مدل (Model Transparency): آگاهی از مجموعه دادههای آموزشی (Training Dataset).
- پروتکلهای تأیید (Verification Protocols): اطمینان از صحت وزنهای مدل (Model Weights Integrity).
- حاکمیت داده (Data Governance): نحوه پردازش و ذخیرهسازی ورودیها توسط مدل.
- ارزیابی آسیبپذیری (Vulnerability Assessment): تست نفوذ دورهای بر روی سرویسهای استنتاج (Inference Endpoints).
جمعبندی و توصیه به مدیران فناوری
آنچه سارا فرایر گوشزد کرد، بازتابی از ضرورت نگاه «امنیتی» به هوش مصنوعی است. سازمانها باید پیش از انتخاب میان مدلهای ارزانقیمت و مدلهای معتبر، هزینهی «نشت داده» و «تخریب برند» را محاسبه کنند. استراتژی پیشنهادی برای تیمهای زیرساختی این است که مدلهای هوش مصنوعی را در محیطهای ایزوله (Sandbox) اجرا کرده و دسترسی آنها به اینترنت و پایگاه دادههای حساس را از طریق فایروالهای لایه اپلیکیشن (WAF) محدود کنند.


