دولت ایالات متحده در راستای بهینهسازی فرآیندهای اداری و کاهش زمان پاسخگویی به درخواستهای دسترسی آزاد به اطلاعات (FOIA)، اقدام به ادغام ابزارهای هوش مصنوعی گوگل در چرخه کاری وزارت امنیت داخلی (DHS) کرده است. این رویکرد جدید که با هدف شناسایی و پیشنهاد بخشهای نیازمند سانسور یا Redaction در اسناد طراحی شده، دریچهای نو به سوی اتوماسیون در سیستمهای بوروکراتیک باز کرده است که همزمان نویدبخش کارایی بالاتر و نگرانیهای عمیق پیرامون شفافیت اطلاعاتی است.
تحلیل معماری فرآیند اتوماسیون در سازمانهای دولتی
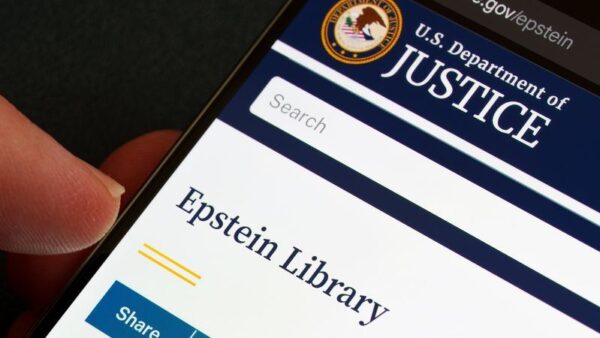
بر اساس مستندات فنی منتشر شده در GitHub که توسط واشنگتنپست بررسی شده، اداره گمرک و حفاظت مرزی ایالات متحده (CBP) به عنوان بازوی زیرمجموعه DHS، مسئولیت اجرای این پایلوت تکنولوژیک را بر عهده دارد. برخلاف سیستمهای مبتنی بر قوانین ثابت (Rule-based)، این ابزارها از مدلهای زبانی و بینایی ماشین گوگل استفاده میکنند تا الگوهای حساسی که باید در اسناد سیاه شوند را شناسایی کنند. این اقدام در حالی صورت میگیرد که پیشتر، وزارت دادگستریلیز اسناد پرونده اپستاین توسط وزارت دادگستری، چالشهای مقیاسپذیری در Redaction دستی میلیونها صفحه سند را به وضوح نشان داده بود.
ابعاد فنی و اهداف عملیاتی تا پایان تابستان ۱۴۰۴
برنامه عملیاتی دولت حاکی از آن است که تا پایان شهریور ۱۴۰۴، بیش از ۱۰ درصد از مجموع درخواستهای FOIA، که رقمی در حدود ۱۰۰,۰۰۰ تا ۱۴۰,۰۰۰ سند را شامل میشود، از فیلتر این سیستمهای هوش مصنوعی عبور خواهند کرد. نکته حائز اهمیت این است که سیستم در اینجا تنها نقش «پیشنهاددهنده» را ایفا میکند و تصمیم نهایی توسط کارشناسان انسانی اتخاذ میشود تا اطمینان حاصل شود که اطلاعات خروجی «دقیق و کامل» باقی میمانند. با این حال، استفاده از اصطلاح «دقیق و کامل» در کنار فرآیند حذف اطلاعات، تناقض پارادوکسی قابل توجهی را ایجاد کرده است.
مشخصات فنی و ابزارهای مورد استفاده در نهادهای دولتی
- وزارت امنیت داخلی (DHS/CBP): استفاده از Google AI Tools برای پیشنهادات هوشمند حذف متون.
- وزارت کشور (Interior Department): بهکارگیری راهکارهای مایکروسافت جهت شناسایی و محافظت از اطلاعات محرمانه وکیل و موکل.
- وزارت دادگستری (DoJ): استفاده از ابزار تخصصی Veritone aiWARE برای Redaction ویدیوهای حجیم.
- وزارت بهداشت و خدمات انسانی (HHS): توسعه ابزار اختصاصی تحت عنوان «FRED» جهت پالایش دادههای ناشناخته.
نگرانیهای ساختاری پیرامون شفافیت و محرمانگی
کارشناسان حقوقی و حوزه شفافیت اطلاعات، دیدگاههای متفاوتی نسبت به این توسعه دارند. در حالی که اتوماسیون میتواند زمان پردازش اسناد را از ماهها به روزها تقلیل دهد، این خطر وجود دارد که «سیاه کردن» خودکار بخشهایی از اسناد به یک ابزار قدرتمند برای پنهانکاری هدفمند تبدیل شود. متخصصان FOIA در دانشگاه فلوریدا هشدار میدهند که اگر الگوریتمهای هوش مصنوعی با سوگیریهای خاص تنظیم شوند، ممکن است اطلاعات عمومی حیاتی بدون بررسی انسانی دقیق و صرفاً بر اساس حدسهای ماشینی، حذف گردند.
نتیجهگیری
استفاده از هوش مصنوعی برای مدیریت اسناد FOIA، گذار از سیستمهای سنتی به عصر هوشمندسازی بوروکراسی را نشان میدهد. با این حال، موفقیت این پروژه تنها در گرو سرعت پردازش نیست، بلکه به شفافیت در نحوه آموزش مدلهای هوش مصنوعی (Training Data) و نظارت انسانی بر تصمیمات الگوریتمها بستگی دارد. در حالی که دولت ایالات متحده مسیر را برای بهرهگیری از زیرساختهای ابری و یادگیری ماشین هموار میکند، جامعه مدنی همچنان بر لزوم پاسخگویی در برابر «الگوریتمهای سانسور» تأکید میورزد.