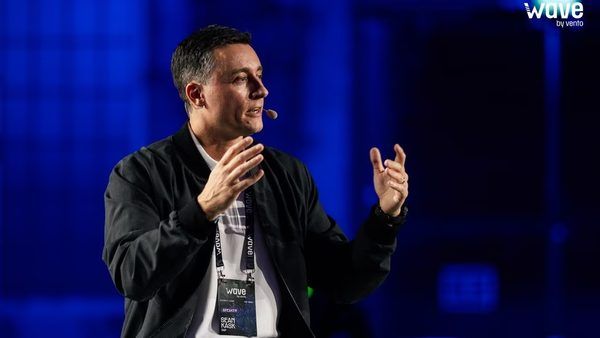
در کنفرانس Wave by Vento که در تورین برگزار شد، شان کاسک، مدیر ارشد استراتژی هوش مصنوعی SAP، هشداری جدی به دنیای نرمافزارهای سازمانی داد: «هر شرکت نرمافزاری باید به یک شرکت هوش مصنوعی تبدیل شود، وگرنه نابود خواهد شد.» این بیانیه نه صرفاً یک شعار تبلیغاتی، بلکه نقشه راهی برای بازنگری در ساختار محصولات نرمافزاری در عصر هوش مصنوعی مولد است.
فراتر از یک قابلیت: معماری مبتنی بر هوش مصنوعی
شان کاسک معتقد است که اضافه کردن هوش مصنوعی به عنوان یک قابلیت حاشیهای (Feature) در نرمافزارهای سنتی، دیگر کافی نیست. استراتژی SAP تغییر رویکرد از «نرمافزار با هوش مصنوعی» به «هوش مصنوعی در هسته نرمافزار» است. این به معنای بازطراحی رابطهای کاربری (UI) است که در آن کاربران به جای پیمایش در منوهای پیچیده، با زبان طبیعی (Natural Language) خواستههای خود را مطرح کرده و سیستم به صورت پویا جداول و گزارشهای مورد نیاز را تولید میکند.
دادههای جدولی: معدن طلای ۸۰ درصدی
برخلاف هیاهوی موجود پیرامون مدلهای زبانی بزرگ (LLM) که بر دادههای متنی غیرساختاریافته تمرکز دارند، SAP بر روی دادههای جدولی (Tabular Data) متمرکز شده است. کاسک اشاره میکند که اگرچه ۸۰ درصد دادههای کسبوکار غیرساختاریافته هستند، اما ۲۰ درصد باقیمانده که در سطرها و ستونهای دیتابیسها قرار دارند، ۸۰ درصد ارزش اقتصادی یک شرکت را ایجاد میکنند. مدلهای زبانی به دلیل ماهیت ریاضیشان در تحلیل اعداد و دادههای جدولی ضعف دارند؛ اینجاست که مدلهای بنیادی جدولی (Tabular Foundation Models) وارد عمل میشوند.
خرید Prior Labs و استقلال در نوآوری
SAP با سرمایهگذاری بیش از ۱ میلیارد یورو، استارتاپ آلمانی Prior Labs را خریداری کرد تا به توسعه مدلهای جدولی خود سرعت ببخشد. این مدلها که پیشتاز بنچمارک TabArena هستند، میتوانند وظایفی را که قبلاً مستلزم ماهها زمان برای آموزش مدلهای یادگیری ماشین اختصاصی (مانند XGBoost) بود، تنها در چند روز انجام دهند. SAP متعهد شده است که این مدلها را «Open Weight» نگه دارد تا اکوسیستم استارتاپی بتواند بر پایه آنها توسعه یابد.
مشخصات و راهبرد فنی SAP در هوش مصنوعی
- تمرکز اصلی: استفاده از مدلهای بنیادی برای دادههای جدولی جهت تحلیلهای مالی و عملیاتی.
- مدل اختصاصی: استفاده از مدل SAP-RPT-1 در محیطهای عملیاتی.
- استراتژی مدل زبانی: پرهیز از آموزش مدلهای LLM پرهزینه؛ در عوض استفاده از بیش از ۱۰۰ مدل (OpenAI, Anthropic, Mistral, Google) و انتخاب هوشمندانه بهترین مدل برای هر Task.
- زیرساخت دانشی: استفاده از گرافهای دانش (Knowledge Graph) شامل ۵۰۰,۰۰۰ جدول و ۷ میلیون فیلد داده برای افزایش دقت در Agents.
اروپا و اقیانوس سرخ مدلهای زبانی
کاسک به شرکتهای اروپایی هشدار میدهد که وارد «اقیانوس سرخ» رقابت برای آموزش مدلهای زبانی بزرگ نشوند؛ چرا که هزینه ۱۰ میلیارد دلاری برای مدلی که شش ماه بعد قدیمی میشود، توجیه اقتصادی ندارد. به باور او، راهبرد برنده برای اروپا، ساخت داراییهای مکمل است که باعث میشود مدلهای عمومی برای محیطهای تخصصی سازمانی «قابل استفاده» شوند.
نتیجهگیری
آینده صنعت نرمافزار در دست شرکتهایی است که میتوانند دادههای ساختاریافته خود را با مدلهای بنیادی ادغام کنند. همانطور که SAP با خرید شرکتهایی مانند TechWolf و Prior Labs نشان داده است، این اکوسیستم برای بقا نیازمند پیوند میان قدرت پردازشی مدلهای بزرگ و تخصص دامنه در مدلهای جدولی است.