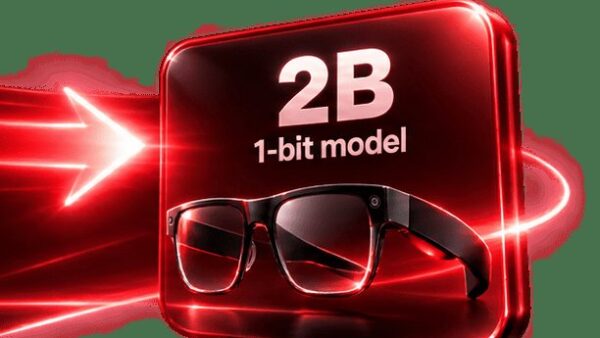
استارتاپ PrismML با رویکردی نوآورانه در حوزه هوش مصنوعی مولد، موفق شده است مدلهای زبانی کوچک (Tiny LLMs) خود را برای اجرا بر روی سختافزارهای کممصرف، بهویژه عینکهای هوشمند مجهز به پلتفرمهای پردازشی کوالکام (Qualcomm) بهینهسازی کند.
دستیابی به هوش مصنوعی با وزن آزاد (Open-Weight) در لبه (Edge)
هدف بلندمدت PrismML حرکت به سمت مدلهای هوش مصنوعی با «وزنهای آزاد» (Open-Weight) است که مستقیماً بر روی دستگاههای کاربر (On-Device) اجرا میشوند. برخلاف مدلهای سنگین که نیازمند اتصال مداوم به سرورهای ابری هستند، این مدلها از توان پردازشی نهفته در سختافزار دستگاه استفاده میکنند. این انتقال پردازش از فضای ابری به لبه، نه تنها تأخیر را به حداقل میرساند، بلکه حریم خصوصی کاربران را با عدم ارسال دادههای حساس به سرورهای خارجی تضمین میکند.
همافزایی با معماری پردازشی کوالکام
بهینهسازی انجام شده توسط تیم PrismML به گونهای است که از واحدهای پردازش عصبی (NPU) و شتابدهندههای گرافیکی در چیپستهای کوالکام بهره میبرد. این همافزایی باعث میشود تا مدلهای زبانی با کمترین مصرف انرژی، وظایف پردازش متن و تحلیل محیطی را در لحظه و بدون داغ کردن بیش از حدِ عینکهای هوشمند انجام دهند.
مشخصات و قابلیتهای کلیدی:
- معماری مدل: مدلهای زبانی کوچک (Tiny LLMs) با پارامترهای بهینهشده برای پردازش محلی.
- سختافزار میزبان: پلتفرمهای محاسباتی کوالکام (Qualcomm Snapdragon) در عینکهای هوشمند.
- مزیت اصلی: اجرای آفلاین (On-Device AI) و کاهش چشمگیر تاخیر در پاسخدهی.
- نوع مدل: مبتنی بر وزنهای آزاد (Open-Weight AI) برای انعطافپذیری بیشتر توسعهدهندگان.
چشمانداز آینده
این پیشرفت که در شهریور ۱۴۰۵ (سپتامبر ۲۰۲۶) معرفی شد، نقطه عطفی در توسعه محصولات پوشیدنی هوشمند است. PrismML با تمرکز بر بهرهوری، ثابت کرد که برای داشتن یک دستیار هوشمند قدرتمند روی صورت کاربر، نیازی به ابرهای محاسباتی حجیم نیست و میتوان با تکیه بر معماری کارآمد و مدلهای سبک، تجربه کاربری مشابه سیستمهای ابری را ارائه داد.