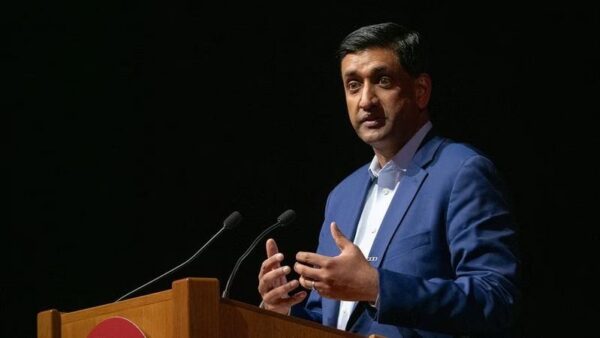
در تحولی مهم در عرصه سیاستگذاری فناوری در ایالات متحده، رو کانا (Ro Khanna)، نماینده کنگره از کالیفرنیا، از طرح لایحه جدیدی با عنوان «قانون کنترل انسانی بر هوش مصنوعی» (Human Control Over AI Act) پرده برداشت که هدف آن مقابله با خطرات بالقوه مدلهای هوش مصنوعی با قابلیت خودبهسازی (Self-improving AI) و ایجاد نهادهای نظارتی سختگیرانه برای شرکتهای پیشرو در این صنعت است.
تهدید وجودی و توقف مدلهای خودبهسازی
رو کانا در مصاحبههای اخیر خود با اشاره به ریسکهای تمدنی، تأکید کرده است که مدلهای هوش مصنوعی که به صورت بازگشتی خود را بهبود میبخشند یا قادر به تغییر اهداف بنیادی، سیستمهای کنترل و مکانیسمهای خاموشی خود هستند، باید تا زمان تدوین چارچوبهای ایمنی فدرال کاملاً ممنوع شوند. این لایحه تمرکز ویژهای بر جلوگیری از توسعه مدلهایی دارد که میتوانند بدون نظارت انسانی، کدهای خود را بازنویسی کنند و به سطحی از خودفرمانی برسند که فراتر از مدیریت طراحان آنهاست.
ایجاد نهاد نظارتی فدرال و بازرسیهای مستقل
این طرح پیشنهادی، ساختار جدیدی را برای نظارت بر غولهای فناوری نظیر OpenAI، Anthropic، Google DeepMind و xAI در نظر میگیرد. طبق مفاد این لایحه، یک آژانس فدرال جدید برای صدور مجوز آموزش و استقرار مدلهای پیشرو ایجاد خواهد شد. از ویژگیهای کلیدی این نهاد، استقرار بازرسان مستقل در آزمایشگاههای پیشرو است که گزارشهای خود را مستقیماً به آژانس ارائه میدهند.
- ممنوعیت مدلهای با قابلیت خودبهسازی بازگشتی تا پیش از اخذ مجوز فدرال.
- الزام به پیادهسازی مکانیسمهای ایمنی (Kill Switches) و محیطهای ایزوله (Air-gapped sandboxes).
- ایجاد مجازاتهای کیفری برای کارکنانی که عمداً سیستمهای حفاظتی را غیرفعال کنند.
- طبقهبندی توسعه هوش مصنوعی که منجر به آسیبهای جمعی شود به عنوان جنایت علیه بشریت.
- تنظیم مقررات بر سختافزارهای پردازشی پیشرفته (تراشههای هوش مصنوعی).
رویکرد بینالمللی و رقابت استراتژیک
بخشی از استراتژی رو کانا، تعامل با بازیگران بینالمللی برای جلوگیری از پیشرویهای بیمهابا در رقابتهای جهانی است. وی با ارسال نامههایی به شرکتهای چینی نظیر DeepSeek و Alibaba، خواستار شفافیت در مورد تحقیقات آنها پیرامون ابرهوش (Superintelligence) شده است. این لایحه همچنین از دولت میخواهد تا با استفاده از ابزارهایی نظیر کنترلهای صادراتی هدفمند و توافقنامههای قابل اجرا، از دستیابی رقبای استراتژیک به توانمندیهای هوش مصنوعی خطرناک جلوگیری کند.
پیامدهای حقوقی و فنی
این لایحه تنها به محدودیتهای نرمافزاری بسنده نمیکند؛ بلکه با اجباری کردن بیمه مسئولیت مدنی برای شرکتهای هوش مصنوعی، گام مهمی در جهت پاسخگو کردن توسعهدهندگان برمیدارد. با توجه به هشدارهای اخیر بیش از ۲۰ پژوهشگر در مورد «انفجار هوش» در صورت خودکارسازی تحقیقات توسط خود مدلها، این لایحه تلاش دارد از وقوع سناریوهایی مانند نفوذهای اخیر در پلتفرمهایی نظیر Hugging Face جلوگیری کند. در نهایت، تا زمان برگزاری انتخابات میاندورهای، بحثهای پیرامون این طرح در کنگره ادامه خواهد داشت و به عنوان الگویی برای آینده ایمنی هوش مصنوعی مطرح است.