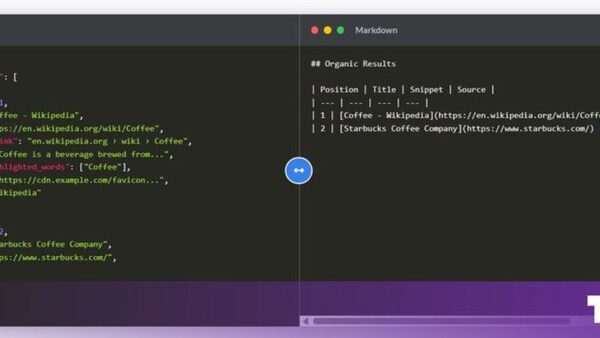
در تحولی قابلتوجه در زیرساختهای هوش مصنوعی در پاییز ۱۴۰۳، شاهد تغییر پارادایمی از فرمتهای دادهای ساختاریافته سنتی نظیر JSON به سمت مارکداون (Markdown) به عنوان زبان مرجع برای تعامل بین موتورهای جستجو و مدلهای زبانی بزرگ (LLM) هستیم.
چرا مارکداون از JSON پیشی میگیرد؟
برای سالها، JSON به عنوان استاندارد بیچون و چرای تبادل داده بین سرویسهای وب شناخته میشد. با این حال، با ظهور عصر LLMها، محدودیتهای این فرمت آشکار شده است. JSON برای ماشینها بهینهسازی شده است؛ در حالی که مدلهای زبانی با حجم عظیمی از دادههای متنی غیرساختاریافته آموزش دیدهاند. مارکداون به دلیل شباهت ساختاری به زبان طبیعی و در عین حال دارا بودن نشانهگذاریهای معنایی (Semantic Markup)، به مدلهای هوش مصنوعی اجازه میدهد تا ساختار اسناد را بهتر درک کنند بدون اینکه پیچیدگیهای نحوی (Syntax) JSON باعث اتلاف منابع پردازشی در توکنسازی (Tokenization) شود.
بهینهسازی در سطح توکن و هزینه محاسباتی
یکی از دلایل اصلی جایگزینی، کاهش مصرف توکن است. در یک ساختار پیچیده JSON، کروشهها، گیومهها و فیلدهای تکراری بخش بزرگی از پنجره کانتکست (Context Window) مدل را اشغال میکنند. در مقابل، مارکداون با استفاده از نمادهای ساده مانند # برای تیترها یا ** برای بولد کردن، اطلاعات ساختاری را با کمترین نرخ توکنسازی ارائه میدهد. این امر مستقیماً به معنای کاهش هزینههای استنتاج (Inference) و افزایش دقت مدل در استخراج مفاهیم کلیدی از دادههای بازیابی شده (RAG) است.
معماری مدرن RAG و نقش Markdown
در معماریهای RAG (جستجوی بازیابیمحور)، دادهها باید پیش از پردازش توسط LLM، به شکلی خوانا آمادهسازی شوند. مارکداون به عنوان یک استاندارد واسط، اجازه میدهد دادههای خام از دیتابیسهای برداری یا موتورهای جستجو بدون نیاز به پاکسازیهای سنگین، مستقیماً توسط مدل پردازش شوند. این یعنی جداسازی هوشمندانه بخشهای غیرضروری از بدنه اصلی متن که در فرمتهای حجیم JSON به سختی قابل تفکیک هستند.
مشخصات فنی و مقایسهای فرمتها
- خوانایی انسانی: مارکداون به راحتی توسط انسان قابل ویرایش است (JSON در ابعاد بزرگ دشوار است).
- بهینهسازی توکن: مارکداون نسبت به JSON در دادههای حجیم متنی، حجم توکن کمتری اشغال میکند.
- سازگاری با آموزش: LLMها به طور ذاتی با ساختار Markdown در حین آموزش (Training) آشنایی بیشتری دارند.
- پشتیبانی از فرمتبندی: مارکداون به سادگی جداول، لینکها و لیستها را نمایش میدهد که برای مدل جهت تحلیل ساختاری ایده آل است.
نتیجهگیری
حرکت به سمت مارکداون نشاندهنده بلوغ زیرساختهای هوش مصنوعی است. همانطور که در اواخر ۱۴۰۳ میبینیم، صنایع به دنبال راههایی هستند تا دادهها را به «زبان مدلها» نزدیکتر کنند. اگرچه JSON همچنان در انتقال دادههای سیستمی بین APIها جایگاه خود را حفظ خواهد کرد، اما برای دادههایی که قرار است توسط مدلهای زبانی تفسیر شوند، مارکداون بیشک استاندارد برتر خواهد بود.