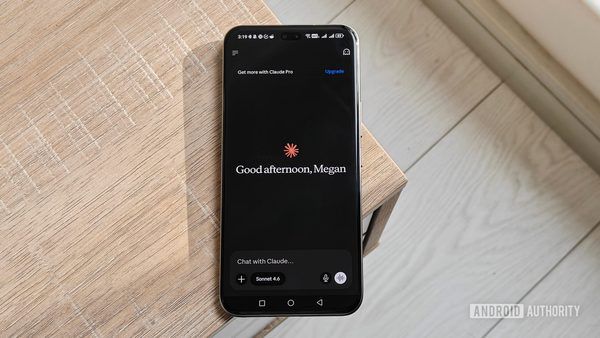
شرکت Anthropic، توسعهدهنده پیشرو در حوزه هوش مصنوعی مولد، در راستای ارتقای استانداردهای اخلاقی و ایمنی، سیاستهای جدید و سختگیرانهای را برای مقابله با سوءاستفادههای کاربران از مدل زبانی Claude وضع کرده است. این رویکرد جدید که در بهار ۱۴۰۴ ابلاغ شده، مستقیماً بر جلوگیری از آزار کلامی، قلدری دیجیتال و تولید محتوای آسیبزا متمرکز است.
شناسایی و مقابله با الگوهای رفتاری مخرب
یکی از چالشهای اساسی در توسعه مدلهای زبانی بزرگ (LLM)، پدیده تعاملات سوءاستفادهگرانه کاربران با رباتهای چت است. گزارشهای اخیر نشان میدهد که برخی کاربران با استفاده از زبانی تند، تحقیرآمیز یا تکرار الگوهای «قلدری»، تلاش میکنند مرزهای اخلاقی مدل را به چالش بکشند. Anthropic با بازبینی پروتکلهای نظارتی خود، مکانیزمهای تشخیص متن را بهگونهای بهینه کرده است که الگوهای توهینآمیز را در زمان واقعی (Real-time) شناسایی و با محدودسازی دسترسی کاربران متخلف، از تکرار این رفتارها جلوگیری کند.
تأثیر سیاستهای حفاظتی بر تجربه کاربری
اگرچه ممکن است برخی این سختگیریها را محدودکننده تصور کنند، اما تحلیلگران معتقدند که این اقدام برای حفظ سلامت روانشناختی مدل و جلوگیری از «سمی شدن» دادههای خروجی ضروری است. هنگامی که یک مدل هوش مصنوعی به طور مداوم در معرض ورودیهای پرخاشگرانه قرار میگیرد، احتمال انحراف در لحن و محتوای پاسخهای آن در تعاملات بعدی افزایش مییابد. سیاست جدید Anthropic تضمین میکند که تعامل با Claude در محیطی امن و حرفهای باقی بماند.
معماری نظارتی و سیستم گزارشدهی
سیستم جدید نظارت بر سوءاستفاده، لایهای از تحلیلهای مبتنی بر یادگیری ماشین را به واسط کاربری اضافه کرده است. این سیستم تنها به بررسی کلمات کلیدی اکتفا نمیکند، بلکه با تحلیل معنایی (Semantic Analysis) قصد و نیت پشت پیامهای ارسالی را نیز درک میکند. کاربران در صورت مشاهده خطاهای سیستم یا مسدودسازیهای ناعادلانه، میتوانند از طریق داشبورد امنیتی خود نسبت به بازبینی پرونده اقدام کنند.
مشخصات فنی و اجرایی سیاست نظارتی جدید
- نوع سیستم شناسایی: تحلیل معنایی متنی (Contextual Semantic Analysis).
- دامنه اعمال قانون: تمامی پلتفرمهای دسترسی به مدل شامل API و وبسایت Claude.
- پیامد نقض قوانین: از هشدار سیستمی تا تعلیق دائمی دسترسی کاربری.
- اهداف کلیدی: حذف قلدری (Bullying)، جلوگیری از ترویج خشونت و حفظ امنیت دادههای آموزشی.
نتیجهگیری و آینده اخلاق در هوش مصنوعی
اقدام Anthropic نشاندهنده یک تغییر پارادایم در مدیریت پلتفرمهای هوش مصنوعی است. همانطور که در مسیر توسعه مدلهای پیشرفتهتر مانند نسخه Claude 3.5 و فراتر از آن حرکت میکنیم، نقش «حکمرانی هوش مصنوعی» (AI Governance) از یک مقوله حاشیهای به یکی از اجزای اصلی معماری سیستم تبدیل شده است. این سیاستها نه تنها Claude را ایمنتر میکند، بلکه الگویی برای سایر توسعهدهندگان ارائه میدهد تا توازنی میان آزادی عمل کاربر و مسئولیتهای اخلاقی ایجاد کنند.