مقدمهای بر انقلاب مدلهای هوش مصنوعی نوین
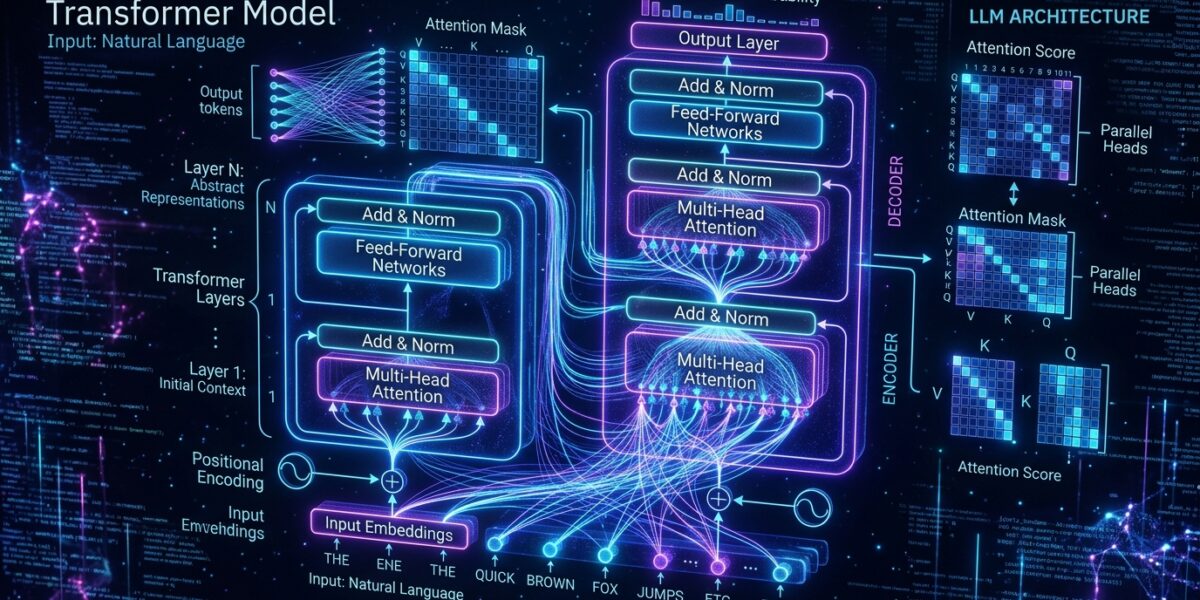
مدلهای زبانی بزرگ (Large Language Models) در سالهای اخیر مرزهای درک ماشینی و تولید محتوا را به شکل چشمگیری جابجا کردهاند. امروزه معماریهای مدرن بر پایهی ترانسفورمرها، مکانیزمهای توجه بهینهسازی شده (FlashAttention) و فرآیندهای استدلال گامبهگام (Chain-of-Thought) طراحی میشوند.
معماریهای مدرن هوش مصنوعی با بهرهگیری از تکنیکهای MoE (Mixture of Experts) توانستهاند با مصرف منابع پردازشی کمتر، به بالاترین دقت استدلالی دست یابند.
نمونه کد پایتون برای اتصال به API مدلهای مدرن
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ.get("AI_API_KEY"),
base_url="https://api.openai.com/v1"
)
response = client.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "system", "content": "شما یک دستیار متخصص برنامهنویسی و هوش مصنوعی هستید."},
{"role": "user", "content": "تفاوتهای کلیدی معماری Mixture of Experts را توضیح دهید."}
],
temperature=0.7
)
print(response.choices[0].message.content)
چالشهای استقرار محلی و بهینهسازی حافظه (VRAM)
برای توسعهدهندگان، اجرای مدلهای منبعباز نظیر LLaMA و DeepSeek بر روی سرورهای داخلی نیازمند روشهای کوانتیزاسیون پیشرفته مانند AWQ و GGUF است که امکان اجرای مدلهای ۷۰ میلیاردی را با کارتهای گرافیک سازمانی فراهم میسازد.