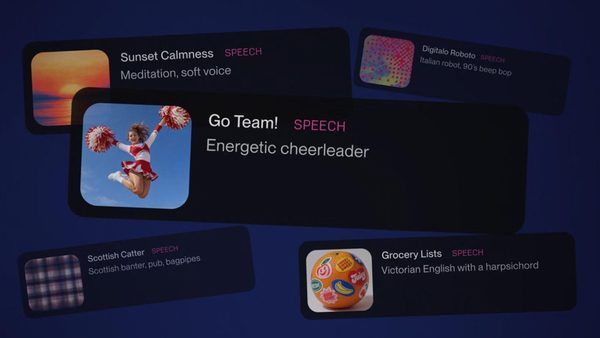
پلتفرم Suno، که تا پیش از این به عنوان یکی از پیشگامان در تولید موسیقی مبتنی بر هوش مصنوعی شناخته میشد، با معرفی قابلیت جدید Speech، مرزهای فعالیت خود را از تولید آثار موسیقایی فراتر برده و وارد حوزه تولید «گفتار» (Speech Generation) شده است. این قابلیت که هماکنون به صورت نسخه بتای عمومی در پلتفرمهای وب و موبایل در دسترس قرار گرفته، به کاربران اجازه میدهد تا با استفاده از متن یا دستورات متنی (Prompts)، صداهای انسانی واقعگرایانه تولید کرده و آنها را با موسیقی پسزمینه به صورت یکپارچه ترکیب کنند.
گامی فراتر از نتنویسی: ورود به دنیای گفتار
شرکت Suno با معرفی مدل صوتی جدید خود، تلاش دارد تا به یک ابزار کامل برای تولید محتوای صوتی تبدیل شود. جک برودی، مدیر ارشد محصول Suno، در اطلاعیه رسمی خود تأکید کرده است که اگرچه «موسیقی همواره هسته اصلی ماموریت Suno باقی خواهد ماند»، اما چشمانداز این شرکت همواره فراتر از موسیقی بوده و به سایر اشکال بیان انسانی گسترش یافته است. با این بهروزرسانی، کاربران نه تنها میتوانند قطعات موسیقی، بلکه نریشن، گویندگی و محتوای صوتی گفتاری را نیز در همان محیط کاربری ایجاد کنند.
معماری یکپارچه: همگامی هوشمند موسیقی و کلام
یکی از نقاط قوت فنی در ابزار جدید Suno، قابلیت تولید همزمان (Simultaneous Generation) است. در بسیاری از سیستمهای سنتی، کاربر مجبور بود برای تولید یک پادکست یا محتوای تبلیغاتی، ابتدا فایل گفتار را در یک نرمافزار تدوین صدا (DAW) تولید کرده و سپس موسیقی را روی آن لایه اضافه کند. مدل جدید Suno به گونهای طراحی شده است که موسیقی و گفتار را در یک جریان کاری (Workflow) به هم پیوند میدهد. این مدل به کاربران اجازه میدهد تا لحن (Tone) و سبک گویندگی را از طریق پرامپتها کنترل کنند، که نتیجه آن هماهنگی ریتمیک و احساسی میان محتوای متنی و فضای صوتی پسزمینه است.
کاربردهای عملی و پتانسیلهای خلاقانه
قابلیت جدید Speech در Suno، طیف وسیعی از کاربردها را برای تولیدکنندگان محتوا ممکن میسازد. از جمله این کاربردها میتوان به موارد زیر اشاره کرد:
- تولید محتوای آموزشی: ساخت ویدیوهای آموزشی یا اسلایدهای ناطق با صدای طبیعی.
- تولید پادکستهای کوتاه: ایجاد محتوای داستانی یا خبری که موسیقی پسزمینه آن متناسب با متن تغییر میکند.
- صنعت تبلیغات: تولید آنی تیزرهای تبلیغاتی رادیویی یا ویدیویی با ترکیب صدای نریتور و موسیقی اختصاصی.
مشخصات فنی مدل Speech در پلتفرم Suno
- نوع مدل: مدل تولیدکننده صوتی (Audio Generative Model) مبتنی بر یادگیری عمیق.
- دسترسی: نسخه بتای عمومی (Public Beta) بر روی وبسایت و اپلیکیشن موبایل.
- قابلیتهای کلیدی: تولید متن به گفتار (TTS) با قابلیت کنترل لحن، ترکیب لایههای موسیقی و کلام، پشتیبانی از پرامپتهای توصیفی.
- حوزه کاربرد: تولید محتوای چندرسانهای، گویندگی خودکار، ساخت موسیقی متنی (Soundtrack).
چالشها و نگاه به آینده در پاییز ۱۴۰۳
ورود Suno به حوزه Speech، رقابت را در بازار تولید صدا با هوش مصنوعی داغتر از همیشه میکند. در حالی که مدلهای رقیبی مانند ElevenLabs یا OpenAI Voice Engine بر دقت در تقلید صدا تمرکز دارند، ارزش پیشنهادی Suno در «یکپارچگی هنری» نهفته است. در پاییز ۱۴۰۳، شاهد هستیم که توسعهدهندگان بیش از هر زمان دیگری به سمت «مدلهای چندوجهی» (Multimodal) حرکت میکنند که در آن مرز میان موسیقی، جلوههای صوتی و گفتار انسانی در حال کمرنگ شدن است. باید دید که آیا Suno در ماههای آینده قابلیتهای پیشرفتهتری نظیر کلونینگ دقیق صدا یا پشتیبانی از زبانهای غیرانگلیسی با لهجههای بومی را نیز به این ماژول اضافه خواهد کرد یا خیر.