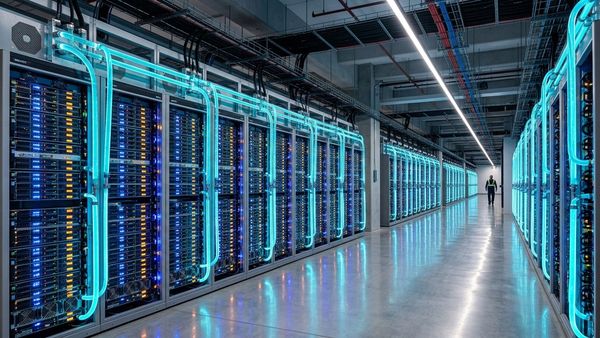
در حالی که زیرساختهای هوش مصنوعی در ایران و جهان با گلوگاههای جدی در سرعت خواندن و نوشتن دادهها مواجه هستند، معرفی نسل جدید SSDهای سری GP کیوکسیا با دستیابی به رکورد خیرهکننده ۲۰ میلیون عملیات ورودی و خروجی در ثانیه (IOPS)، نقطه عطفی در مهندسی ذخیرهسازی مدرن به شمار میآید.
تحول در معماری حافظه: فراتر از مرزهای فلش NAND
شرکت کیوکسیا (Kioxia) با ارتقای نسل سوم فناوری اختصاصی خود یعنی XL-FLASH، موفق شده است فاصله کارایی میان حافظههای مبتنی بر فلش (NAND Flash) و حافظههای موقت گرانقیمت DRAM را به حداقل برساند. در معماری جدید، مهندسان کیوکسیا با کاهش طول سیمکشیهای Word و Bit، موفق به کاهش قابلتوجه تأخیر ناشی از مقاومت و خازن (RC Delay) شدهاند. این بهینهسازی فنی در سطح لایه فیزیکی تراشه، اجازه میدهد تا نرخ پردازش دادهها در بلوکهای ۵۱۲ بایتی به سطحی برسد که پیش از این تنها در حافظههای پرسرعت سیستمعامل ممکن بود.
تاثیر بر زیرساختهای هوش مصنوعی و دیتاسنترها
یکی از چالشهای اصلی در آموزش مدلهای کلان هوش مصنوعی، سرعت انتقال دادهها از فضای ذخیرهسازی به پردازشگرهای گرافیکی (GPU) است. معماری نسل جدید GP1 کیوکسیا که با بهرهگیری از رابط PCIe 6.0 و پروتکل NVMe 2.2 طراحی شده، امکان دسترسی مستقیم پردازنده به حافظه را فراهم میکند. این امر نه تنها برای دیتاسنترهای مقیاسپذیر بلکه برای کسبوکارهای دیجیتالی که نیازمند پردازشهای لحظهای و Real-time هستند، یک تغییر پارادایم محسوب میشود.
مهندسی دقیق: از تأخیر ۵ میکروثانیه تا مقیاسپذیری صفحات
تکنولوژی XL-FLASH در نسل سوم خود با افزایش تعداد صفحات حافظه در هر قالب (Die) نسبت به نسل دوم، تراکم داده را بدون قربانی کردن سرعت افزایش داده است. در حالی که نسل اول GP1 با بهرهگیری از سلولهای MLC و حالت سریعتر SLC، تأخیر خواندن را به کمتر از ۵ میکروثانیه رسانده بود، نسخه جدید با استفاده از بهبودهای ساختاری، سرعت خواندن را تا سه برابر و سرعت نوشتن را تا ۱۵۰ درصد بهبود بخشیده است. این ارقام نه تنها برای محیطهای عملیاتی، بلکه برای دوام سختافزاری نیز حیاتی هستند؛ چرا که پایداری عملیاتی در دیتاسنترها با شاخص DWPD (تعداد نوشتن کامل ظرفیت در روز) سنجیده میشود.
مشخصات کلیدی و تحلیل فنی
- نرخ عملیاتی: ۲۰ میلیون IOPS (برای بلوکهای ۵۱۲ بایتی)
- رابط اتصال: PCIe 6.0 با پروتکل NVMe 2.2
- تکنولوژی هسته: نسل سوم XL-FLASH با کاهش RC Delay
- بهینهسازی پردازشی: دسترسی مستقیم GPU به فضای ذخیرهسازی
- پایداری: متکی بر سلولهای MLC با قابلیت اجرای حالت سریع SLC
نتیجهگیری برای بازار ایران
برای سازمانها و ارائهدهندگان خدمات ابری در ایران که در پی نوسازی زیرساختهای خود برای میزبانی سرویسهای مبتنی بر هوش مصنوعی هستند، ظهور چنین محصولاتی نویدبخش کاهش هزینههای عملیاتی به دلیل نیاز کمتر به خرید ماژولهای حجیم DRAM است. با این حال، بهرهمندی از این سرعت نیازمند بازنگری در کل زنجیره زیرساخت، از جمله سوییچهای شبکه و کنترلرهای مبتنی بر استانداردهای جدید انتقال داده است.